11月2日,美团正式发布新一代大模型LongCat-2.5。这是一款面向长程智能体任务的原生多模态模型,总参数量1.6万亿,每个token激活约480亿参数,训练全程由国产算力完成。继6月LongCat-2.0首次在国产算力上跑通万亿参数模型全流程训练与推理后,2.5版本进一步强化了原生视觉理解与智能体编程能力。
原生多模态:视觉与文本统一处理
LongCat-2.5将视觉信号表示为多层级离散token,让主干模型以统一的token形式处理视觉与文本输入。这意味着它不再需要额外的视觉编码分支,而是原生理解图片、界面与文档,在Visual Coding任务上表现出色,并支持创意设计和3D等任务。

围绕数据合成、环境构建与跨Harness混合训练,团队持续扩展训练链路,还把真实Agent的失败轨迹转化为可复现、可验证的训练任务,针对能力短板不断补充数据。在复杂代码库开发、完整项目构建等端到端工程任务上,模型表现明显提升。这种”用真实任务反哺训练”的做法,让模型在工程场景的适应能力不断增强。
国产算力上的工程突破
针对国产算力单卡显存小的挑战,美团围绕超节点优化任务分工,让参数与任务数据的主要通信在超节点内的高速互联网络中完成。在长上下文监督微调任务中,优化后的单卡训练吞吐量较DDP基线提升86%,相当于一张卡完成原来约1.86张卡的工作量。
推理侧采用W4A4方案,将专家权重和激活同时量化至4比特。线上压测显示,相较W8A8 INT8基线,输入处理和逐token生成的吞吐量均提升约四成,首次输出等待时间缩短约16%,后续每个token的生成耗时缩短约20%。

基准成绩与落地
在AutomationBench中,LongCat-2.5拿到51.8分,高于Claude-Opus-5的50.3分;BrowseComp得分91.9位列第一。多项主流基准评测的成绩介于Claude-Opus-4.8与Claude-Opus-5之间,部分评测甚至超过Claude-Opus-5。用户可在官网longcat.ai体验,开发者可通过同步上线的API调用模型。
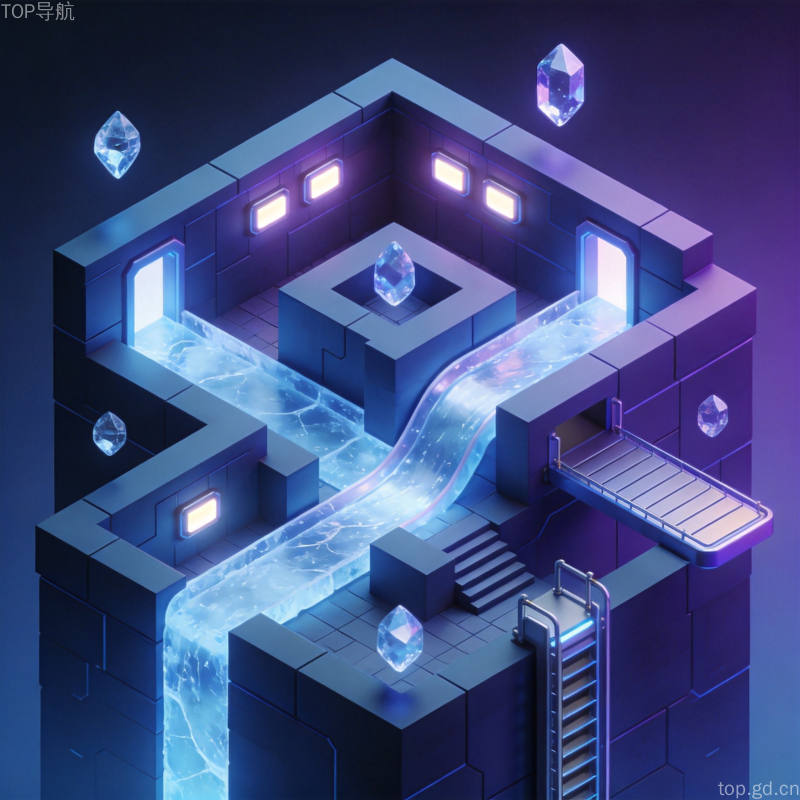
在3DCodeBench的文本生成三维内容任务中,LongCat-2.5同样表现亮眼。这得益于视觉token化与智能体编程能力的深度融合:模型不仅能”看懂”设计稿,还能直接生成可运行的交互页面与3D展示场景,把多模态理解转化为实际的工程产出。对开发者来说,这意味着一个更完整的智能体工作流——从读需求、写代码到验证交付,都可以在模型辅助下闭环完成。
基于LongCat系列,美团还推出了AI经营工作台”妙手”,帮助本地生活商家理解行业指标与品牌规则,并在授权范围内调用工具完成经营任务。从2.0到2.5,国产智能体大模型正在用真实任务表现证明,与国际顶尖产品的差距正在快速缩小。
© 版权声明
文章版权归作者所有,未经允许请勿转载。