9月17日的上海,华为全联接大会2026开幕,轮值董事长汪涛把下一代AI算力家底一次性摊开:昇腾960芯片比原计划提前三个季度就绪,Atlas 960超节点把4096颗NPU连成一台机器,且是全球首个用上NPO近封装光学的超节点。在先进制程受限的背景下,华为选择用”连接”换”算力”。
路线图提前:一年一代,960DT定档2027年一季度
汪涛公布的时间表排到了三年后:昇腾960DT计划2027年第一季度上市,比原定的2027年四季度大幅提前;昇腾960PR在2027年三季度推出;昇腾970定档2028年,昇腾980预计2029年,保持一年一代节奏。
单卡参数同样给得很直白。昇腾960DT的FP8精度算力达到每秒2千万亿次,片上高带宽内存最大288GB,内存访问带宽每秒9.6TB。对比上一代昇腾950,算力直接翻倍。作为参照,英伟达H20带宽为每秒4.8TB,GB200为每秒16TB——960DT的带宽已超过H20,向GB200靠拢。
4096颗芯片靠”光”连成一台机器
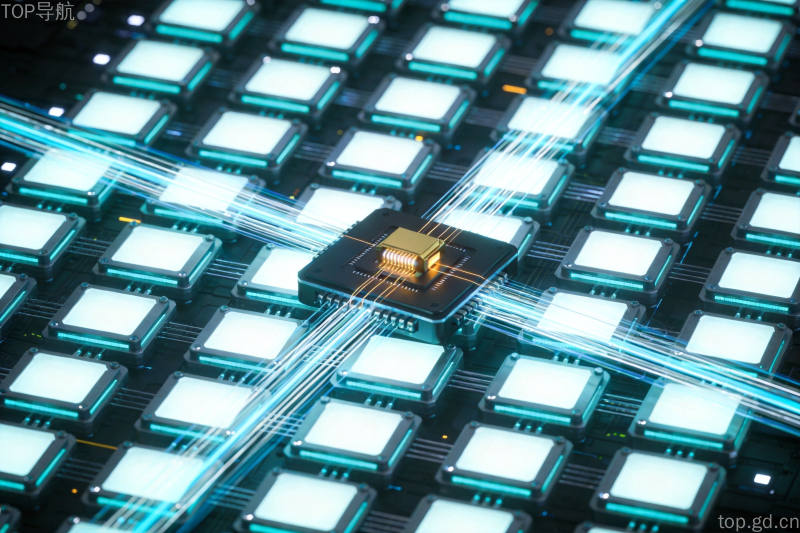
真正的重头戏是Atlas 960超节点。单个超节点实现4096颗NPU高速互联,芯片间通信RTT时延最低只有2微秒,华为称这是当前业界规模最大的超节点,可支撑10万亿参数大模型的训练与推理。
支撑这个规模的是两块底座:自研的灵衢(UnifiedBus)互联协议,以及Hi-ONE光引擎。华为围绕超节点和集群已开发11颗关键芯片,覆盖计算、互联、存储,鲲鹏与昇腾负责核心计算。
Atlas 960也是全球首个应用NPO技术的超节点。NPO把光学器件独立封装、放在芯片附近,让电信号更早转成光信号,缩短高速电路径以降低损耗;与集成度更高的CPO共封装光学相比,NPO的光引擎可插拔、可单独更换,在制造良率和运维成本之间取了平衡。液冷版本计划2027年三季度推出,风冷的Atlas 860则在明年二季度上市。
不比单卡比集群,十万卡集群明年成标配
华为的思路很清楚:单颗芯片性能有差距,就靠成千上万颗芯片高效协同把系统算力拉起来。汪涛判断,十万卡以上的超节点集群在2027年将成为基础配置,十万亿参数很快会成为SOTA模型的起步规模。
需求侧的数据撑着这个判断。他给出的数字是,中国日均Token消耗量从2024年初的千亿增长到2026年6月的约500万亿,两年半翻了近5000倍。目前昇腾超节点已部署1000多套、服务370多家客户,最大集群能支持100万颗AI处理器同时工作。
配套的机房形态也在变。9月15日华为刚在芜湖发布全球首个3D数据中心,供冷、IT设备、供电分层解耦、立体堆叠,单栋机房支持168MW,直接瞄准十万卡集群的供电散热难题。
当然,系统级胜利仍要回答两个老问题:中芯国际代工下的产能能否跟上,以及CANN生态相比CUDA数百万开发者的迁移门槛。路线图已经画到2029年,接下来就看这套”以多取胜”的打法,能不能在真实模型训练里持续兑现。
© 版权声明
文章版权归作者所有,未经允许请勿转载。