10月17日,DeepSeek官方宣布V4.1 Flash更新至V4.1-Flash-1017版本,网页端、APP与API模型已同步切换。这不是全新系列,而是9月发布版本的又一次小步快跑,但更新的含金量并不低:模型性能全面抬升,任务耗时与输出长度双双缩短,多数场景Token用量较前版下降逾50%,而API价格一分未涨。
帕累托前沿首次自主发布
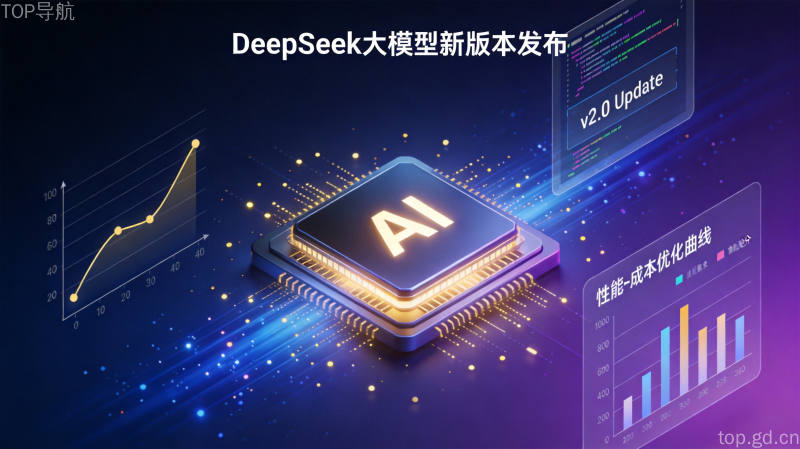
过去大模型厂商公布技术指标,大多是零散罗列跑分。这次DeepSeek第一次主动放出帕累托前沿曲线,把"性能"与"费用"两个维度放到同一张图上。通俗地说,这条曲线代表当前市场上"又强又便宜"的最优边界——你很难再找到另一个模型,在同等成本下达到更高通过率。
V4.1-Flash-1017在这条前沿上表现抢眼。官方数据显示,其单位任务综合成本仅为Fable、Astra等同类模型的百分之一至二十分之一,性价比优势达四五十倍。以DeepSWE v1.1评测为例,旧格局下想拿74%左右的极高通过率,通常要调用各家旗舰模型;而新版本在低思考预算下约1.1元每任务即可达到72.5%,拉满预算后直接登顶全局最高的77.0%,单任务花费仅约1.6元。
从"会答题"到"会建项目"
能力提升不只体现在跑分上。新版通过基于自反馈的强化学习训练,增强了从零构建完整项目的能力,覆盖游戏开发、3D建模等场景,官方称之为承接更多"许愿式"编程任务——你把需求描述清楚,模型帮你把整个项目搭出来。
11项基准测试中,新版本全线高于上一版:Terminal-Bench 4.0从31.2分升至42.3分,ProgramBench从20.3分升至29.1分,DeepSWE v1.1从74.2分增至77.0分;智能体场景同样进步明显,Automation-Bench从54.8升至60.5,Agents' Last Exam从31.8升至35.4,Apex Bench从64.6升至72.1。
效率重构才是重头戏
涨价不是这家公司的风格,1017版本维持原有API价格体系。真正的变化藏在Token使用效率里:通过任务感知型压缩、动态上下文裁剪与自适应解码策略,各类型请求的实际Token消耗被显著压低,多数场景降幅超过50%,企业整体的TCO(总拥有成本)随之继续下探。
模型上下文窗口达到100万个Token,官方建议最大输出设定不少于25.6万个Token。API调用方式不变,老用户继续使用"deepseek-flash"名称即可访问最新模型,无需改动现有程序。
生态适配与搜索能力同步上线
DeepSeek还针对DeepSeek Harness、腾讯CodeBuddy、WorkBuddy等平台框架做了适配优化,建议用户将Harness升级至0.2.1-rc.1或更高版本。
与此同时,DeepSeek API新增网页搜索与抓取能力:Search接口按query返回结构化结果,Fetch接口以Markdown形式抓取单页正文,为Agent与RAG应用提供实时网页内容。单价为每1000次成功请求5元,11月1日起对Server端工具调用按次计费。
从跑分追平旗舰,到Token效率重构,再到搜索接口上线,这次更新没有轰轰烈烈的发布会,却把"性能、成本、生态"三张牌一起打了出来。对开发者而言,这意味着同等预算下可以跑更多任务;对行业而言,性价比这条赛道,又被人往前推了一截。
© 版权声明
文章版权归作者所有,未经允许请勿转载。