10月15日,阶跃星辰正式释放新一代旗舰基座模型Step 5 Preview的模型权重,BF16与FP8双精度版本、技术博客、配套开源开发工具及部署指南同步上线Hugging Face和ModelScope。这是继9月20日该模型发布以来,国产大模型阵营在开源侧的一次重量级动作——一个总参数高达600B的稀疏MoE旗舰,从此向全球开发者全面开放。
600B总参数背后:为什么”激活参数”才是关键
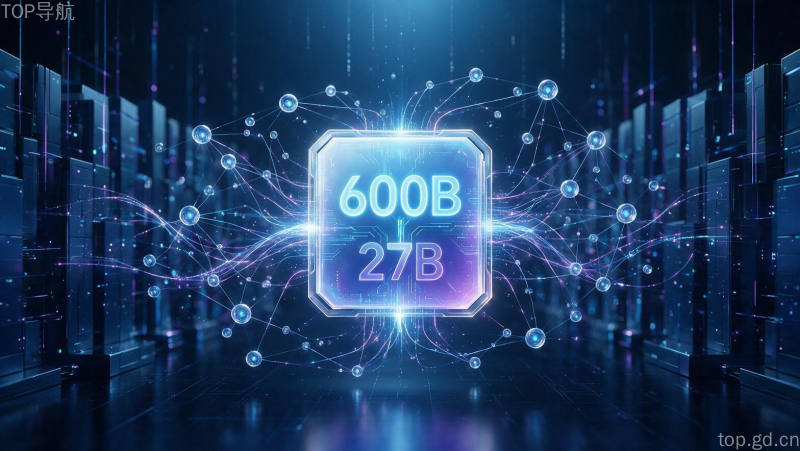
Step 5 Preview采用稀疏MoE架构,总参数量达到600B,但每次推理真正激活的参数量仅有27B。通俗地说,就像一家拥有600名专家的机构,每次处理任务只调动最对口的27人——既保留了庞大的知识储备,又控制住了计算开销。
技术博客透露,该模型采用92层窄深架构,配合Sparse GQA(分组查询注意力)与训练稳定性优化,在大规模训练中保持了收敛质量。百万级可验证环境与长程任务强化学习的引入,让模型在真实世界的Agentic任务中表现更加可靠。
面向长程Agent:100万Token上下文原生支持多模态输入
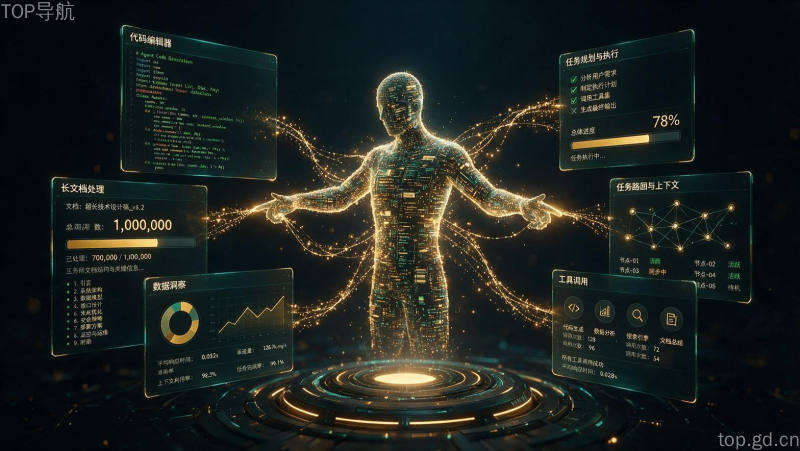
与多数竞品不同,Step 5 Preview的定位非常明确——为长程Agent任务设计。它支持100万Token上下文窗口,原生支持文本与视觉输入,意味着智能体可以一口气”读完”数十万字资料、多张图表后连续执行复杂任务,而无需频繁重新加载记忆。
在应用场景上,该模型覆盖AI编程、软件工程、专业知识工作与金融等领域。阶跃星辰表示,模型已全面开放第三方接口,开发者可以直接在自有应用中调用其推理能力。
开源即登顶:OpenRouter Token用量周榜全球第二
发布即开源的节奏,迅速获得了市场的认可。根据OpenRouter截至2026年10月15日的数据,Step 5 Preview位列该平台Token用量周榜及日榜全球第二,仅次于OpenAI的旗舰模型。对于一个刚刚开放权重的国产模型来说,这样的调用热度并不多见。
对开发者而言,开放权重意味着更大的自由度:既可以通过官方API快速接入,也可以在自有GPU集群上部署、微调,甚至基于权重二次训练。BF16与FP8双版本覆盖了不同推理框架与硬件平台,配合官方部署指南,落地门槛被进一步压低。
从Step 2到Step 5:旗舰迭代的”两年加速”
回看阶跃星辰的产品序列,Step系列几乎保持着每年一代的节奏。从2024年推出Step-1系列确立多模态定位,到2025年Step-2以万亿参数MoE冲击第一梯队,再到今年9月Step 5 Preview发布、10月开放权重,这条迭代曲线正在明显加速。
与上一代相比,Step 5 Preview更强调”能干活”而非”会聊天”:Agent任务执行、代码生成、长文档理解成为主打卖点,这也与当前AI应用从对话走向自主执行的大趋势相吻合。在国产模型普遍追逐Chatbot体验的背景下,把研发重心压向Agent能力的厂商并不多,Step 5 Preview的选择具有标志性意义。
国产开源大模型的”下半场”信号
从参数规模看,600B总参数的稀疏MoE已经站在国际第一梯队;从路线选择看,专注长程Agent而非堆砌通用能力,也让Step 5 Preview在”AI Agent元年”的语境下显得格外应景。当模型权重真正交到社区手里,后续的生态进化速度,或许比参数本身更值得期待。
你会把Step 5 Preview部署到自己的服务器上,还是直接用官方API?欢迎在评论区聊聊你的选择。
© 版权声明
文章版权归作者所有,未经允许请勿转载。